A Anthropic lançou o Claude Opus 5 em 24 de julho de 2026 pelo mesmo preço do Opus 4.8: US$ 5 por milhão de tokens de entrada e US$ 25 na saída, metade do que custa o Fable 5. O modelo mais que dobrou a nota do antecessor no Frontier-Bench (43,3% contra 18,7%) e assumiu o topo do índice da Artificial Analysis com 61 pontos.
Escrevemos este post usando o próprio Opus 5. Vale declarar o óbvio: a Huios é agência, usa Claude em produção desde 2024 e paga essa conta todo mês, então leia os elogios com desconto. O que não tem desconto são os números, e eles contam uma história diferente da que o anúncio conta. Se você chegou aqui tentando decidir qual modelo colocar pra trabalhar, o comparativo de melhor IA para programar cobre a escolha inteira.
O que mudou de verdade
A leitura preguiçosa é "saiu um modelo melhor". A leitura correta é que a Anthropic congelou o preço por token e mexeu no que o modelo gasta pra terminar uma tarefa.
O Opus 5 custa exatamente o que o Opus 4.8 custava. Nenhum centavo a mais. No mesmo dia, ele mais que dobrou a pontuação do antecessor no Frontier-Bench v0.1, o benchmark agêntico de código da própria Anthropic.
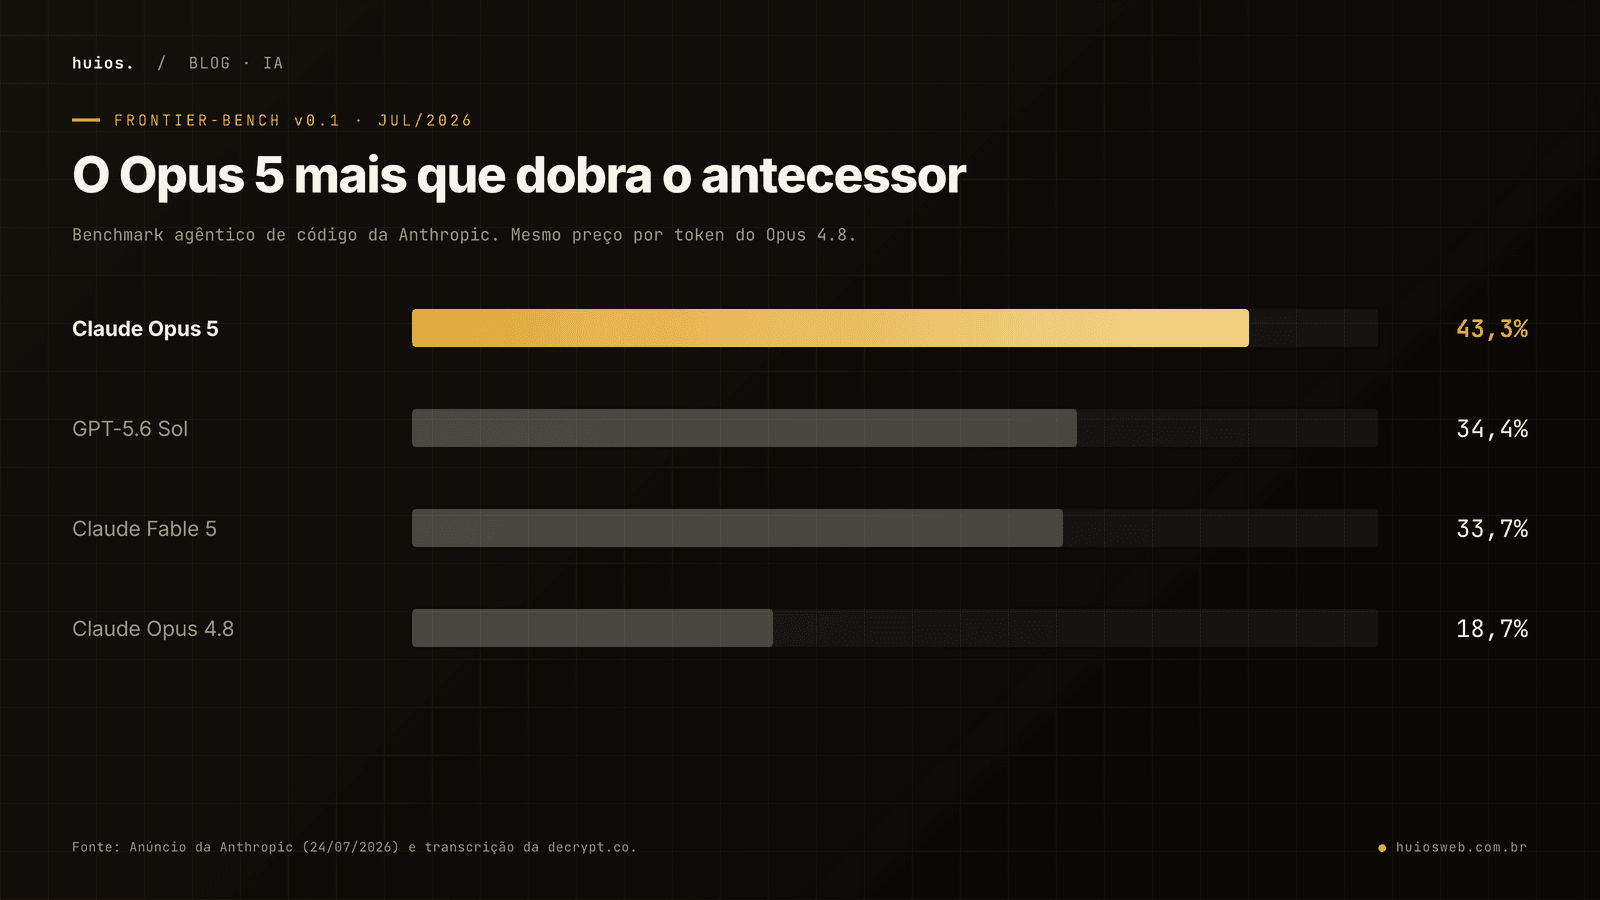
| Modelo | Frontier-Bench v0.1 |
|---|---|
| Claude Opus 5 | 43,3% |
| GPT-5.6 Sol | 34,4% |
| Claude Fable 5 | 33,7% |
| Claude Opus 4.8 | 18,7% |
Segurar o preço enquanto o resultado dobra é um corte de preço disfarçado. Por unidade de trabalho entregue, o Opus 5 saiu bem mais barato que o modelo que ele substitui, e a Anthropic não precisou anunciar promoção nenhuma pra isso.
Preço por token deixou de ser a conta certa
Aqui está a parte que quase todo mundo erra ao montar orçamento de IA.
Você contrata por token, mas paga por tarefa. Um modelo que cobra o dobro e termina o trabalho em um terço das tentativas sai mais barato no fim do mês. É exatamente o que a Artificial Analysis mede quando calcula custo médio por tarefa em vez de preço de tabela.
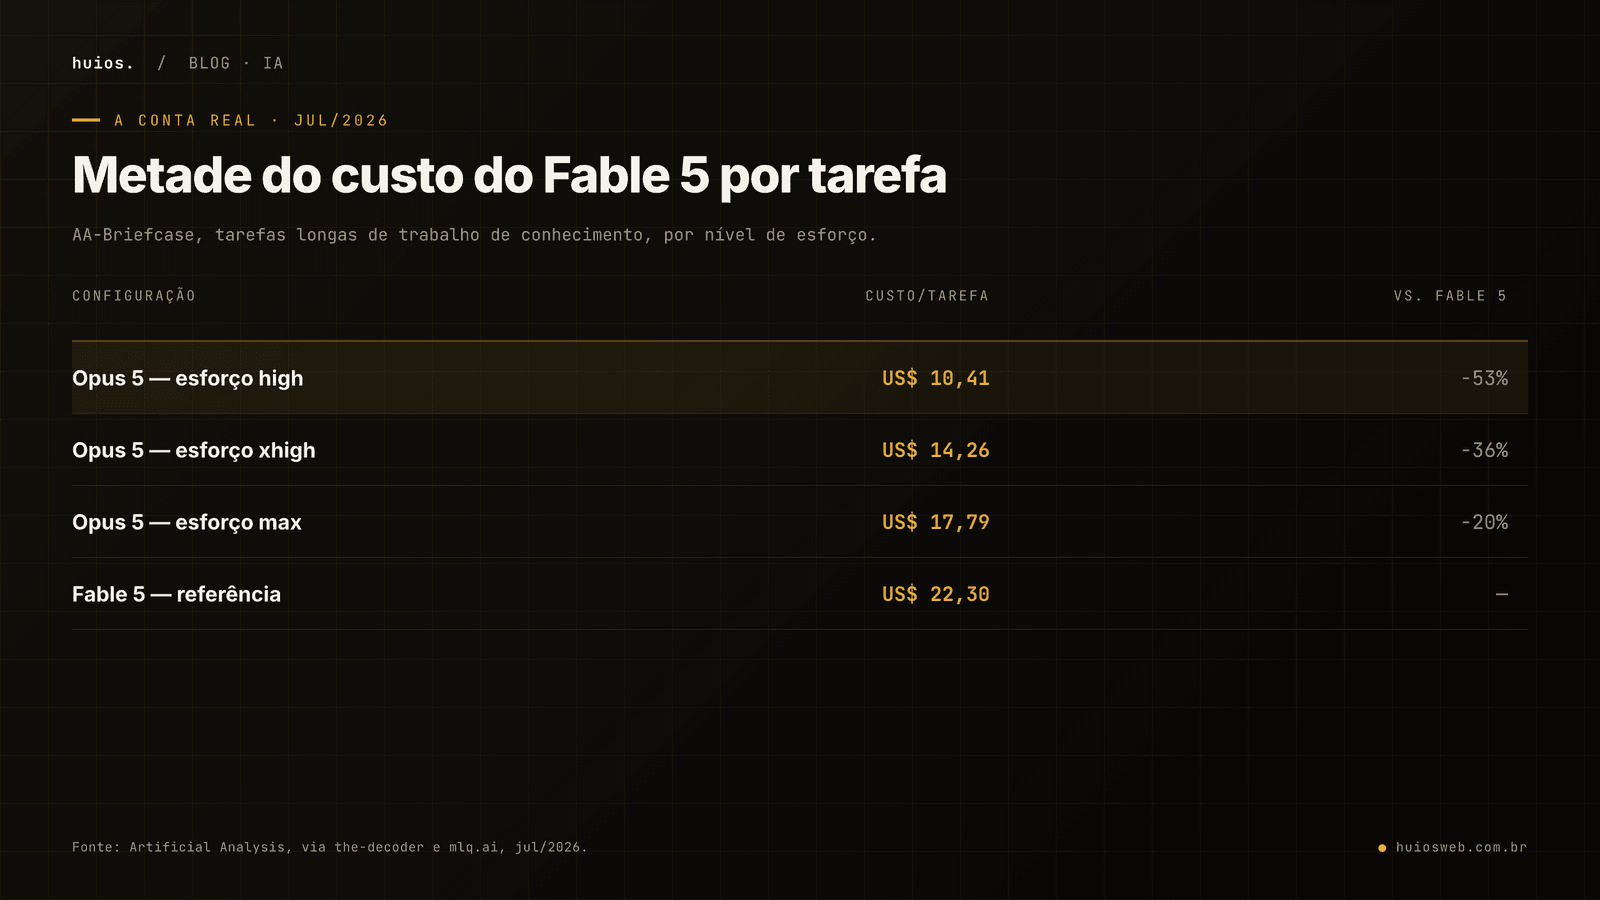
No AA-Briefcase, que mede tarefas longas de trabalho de conhecimento, a diferença fica gritante:
| Configuração | Custo por tarefa | Contra o Fable 5 |
|---|---|---|
Opus 5, esforço high | US$ 10,41 | −53% |
Opus 5, esforço xhigh | US$ 14,26 | −36% |
Opus 5, esforço max | US$ 17,79 | −20% |
| Fable 5, referência | US$ 22,30 | — |
Convertendo a US$ 1 = R$ 5,15, o câmbio que usamos em toda esta série de posts, uma tarefa longa sai de R$ 115 no Fable 5 para R$ 54 no Opus 5 em esforço high. Numa equipe que roda algumas centenas dessas por mês, a diferença paga um salário.
O Sualeh Asif, cofundador do Cursor, resumiu assim: "inteligência perto do Fable 5, na velocidade e no custo do Opus". O Scott Wu, CEO da Cognition, apontou "força particular em depuração difícil e análise de causa raiz".
O dado que contraria o marketing: esforço alto nem sempre ganha
Esta é a descoberta mais útil da semana, e ela não estava no anúncio.
A Vals.ai testou o Opus 5 nos quatro níveis de esforço. O nível xhigh tirou 88,3%. O nível max, que custa muito mais e leva mais de 36 minutos por tarefa, tirou 88,4%. Diferença de um décimo de ponto por várias vezes o preço.
Pior: no Terminal-Bench 2.1 o nível high bate o max. O motivo é prosaico. No esforço máximo o modelo gasta tanto tempo em cada tentativa que sobram menos tentativas dentro do limite de tempo. E as soluções do max tendem a ser mais complexas, o que significa mais superfície pra erro. O high produz solução mais simples, que atende o requisito com mais frequência.
A própria Anthropic define high como padrão na API e no Claude Code. Se você subiu tudo pra max achando que estava comprando qualidade, provavelmente está só pagando mais caro por um resultado igual ou pior. Vale o mesmo raciocínio do controle de esforço e fast mode que já tínhamos documentado.
Onde o Opus 5 perde
Nenhum modelo ganha em tudo, e a Anthropic publicou os números ruins junto com os bons. Um resumo honesto:
- Alucinação subiu. A taxa está em 50%, sete pontos percentuais acima do Opus 4.8. No AA-Omniscience o modelo ficou 11% mais preciso que o antecessor, mas alucinou 6% mais. Mais conhecimento e mais chute vieram no mesmo pacote.
- Epoch AI: 159 contra 161 do Fable 5. O Fable 5 segue na frente no placar geral dessa casa.
- Código agêntico em ambiente genérico. No DeepSWE v1.1 o Opus 5 fez 68,8%, abaixo dos 72,7% do GPT-5.6 Sol.
- Raciocínio de nível especialista. No HLE ficou em 56,3% contra 56,5% do Fable 5. Empate técnico, mas não é vitória.
- Cibersegurança. Continua atrás do Mythos 5. A Anthropic tirou treino ofensivo de propósito, e mesmo assim a capacidade subiu de carona na melhora geral: no OSS-Fuzz o Opus 5 achou vulnerabilidade em 79,4% dos casos contra 80% do Mythos 5. Só que transformar achado em exploit funcionando é outra história, e aí ele fechou 4 desafios contra 13 do Mythos 5. Num benchmark interno de exploração, tirou zero.
Esse último ponto é deliberado e conversa direto com o incidente de agentes de IA em produção que a OpenAI divulgou três dias antes.
Sete modelos de fronteira em sete semanas
O Opus 5 é o quarto lançamento da Anthropic em menos de dois meses. E ele não chegou num vácuo.
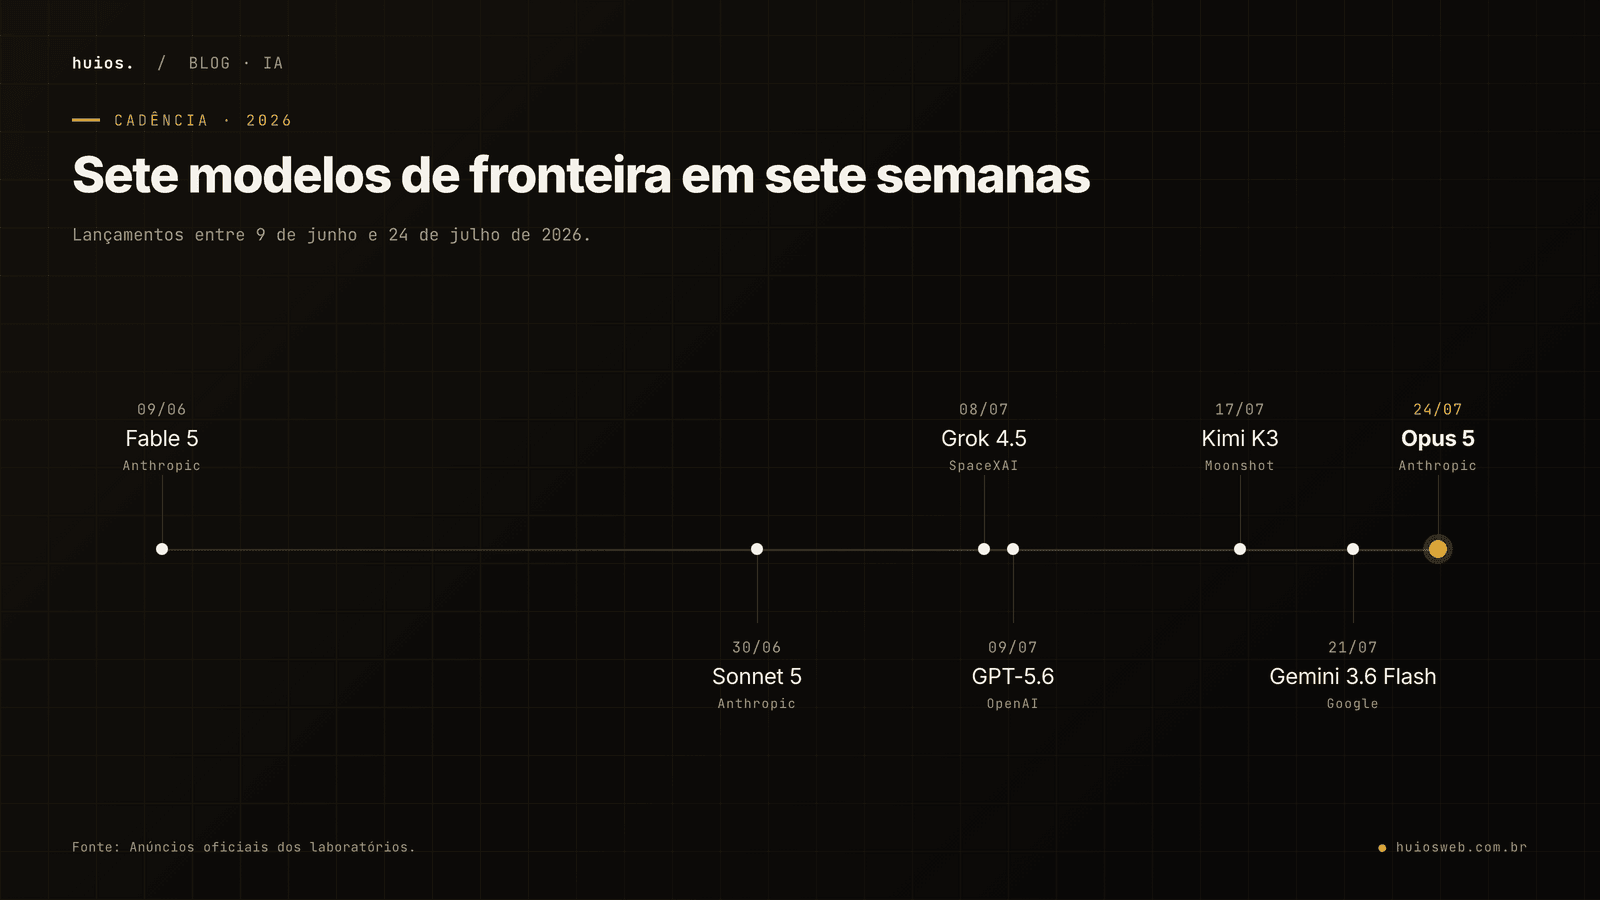
| Data | Modelo | Laboratório |
|---|---|---|
| 09/06 | Claude Fable 5 | Anthropic |
| 30/06 | Claude Sonnet 5 | Anthropic |
| 08/07 | Grok 4.5 | SpaceXAI |
| 09/07 | GPT-5.6 | OpenAI |
| 17/07 | Kimi K3 | Moonshot |
| 21/07 | Gemini 3.6 Flash | |
| 24/07 | Claude Opus 5 | Anthropic |
Dois pontos separam Opus 5 (61), Fable 5 (60) e GPT-5.6 Sol (59) no índice da Artificial Analysis. O Kimi K3, aberto e chinês, aparece com 57. Quando a diferença de capacidade cabe dentro da margem de erro, a decisão de compra migra pra preço, latência e confiabilidade. Foi o que aconteceu.
O que muda no seu bolso
Três coisas concretas:
Reprecifique o que você já roda. Se sua equipe usa Opus 4.8, a troca é gratuita em preço de tabela e vem com resultado melhor. Não existe motivo pra continuar no 4.8.
Pare de subir o esforço por reflexo. Comece em high. Suba só quando medir que subiu junto a taxa de acerto na sua tarefa, não na tarefa do benchmark de outra pessoa.
Cache não é detalhe. Escrita de cache custa US$ 6,25 por milhão com validade de cinco minutos, e a leitura sai por US$ 0,50. Num agente que relê o mesmo contexto o dia inteiro, é a diferença entre uma conta saudável e uma conta absurda.
Vale um alerta que a imprensa quase não cobriu: junto do lançamento, a Anthropic encerrou o uso ilimitado do Fable 5 e migrou pra cobrança por consumo. O teto do plano Max caiu pra metade do anterior, e o Pro passa a cobrar por uso depois da franquia. Se o seu planejamento assumia assinatura de valor fixo, ele envelheceu em 24 de julho.
Quando não usar o Opus 5
Ele não é o modelo certo pra tudo.
Pra tarefa autônoma muito longa, sem ninguém olhando, a própria Anthropic segue recomendando o Fable 5. Pra agente rodando em laço o dia inteiro, com volume alto e tarefa repetitiva, o Sonnet 5 resolve por menos. Pra classificação simples, extração de campo e resumo curto, qualquer modelo do degrau barato faz o serviço, e pagar preço de Opus nisso é desperdício puro.
E se o seu caso envolve dado que não pode sair do país, o preço por token nem entra na conta: a decisão vira de arquitetura antes de virar de modelo. É o tipo de escolha que tratamos junto com desenvolvimento de sistemas.
Perguntas frequentes
Quanto custa o Claude Opus 5?
US$ 5 por milhão de tokens de entrada e US$ 25 por milhão de tokens de saída, o mesmo preço do Opus 4.8 e metade do Fable 5. O modo Fast custa o dobro disso e roda cerca de 2,5 vezes mais rápido. Escrita de cache sai por US$ 6,25 por milhão, com leitura a US$ 0,50.
O Opus 5 é melhor que o Fable 5?
Na maioria dos benchmarks publicados, sim, e por metade do custo por tarefa. Mas o Fable 5 continua à frente no placar geral da Epoch AI, por 161 a 159, e a Anthropic ainda recomenda o Fable 5 para tarefas autônomas muito longas. Para trabalho diário, o Opus 5 é a escolha mais racional.
Vale a pena usar o nível de esforço máximo?
Quase nunca. Nos testes da Vals.ai o nível max tirou 88,4% contra 88,3% do xhigh, custando muito mais e levando mais de 36 minutos por tarefa. No Terminal-Bench, o nível high supera o max porque sobra tempo pra mais tentativas. A Anthropic define high como padrão, e esse padrão está certo.
O Opus 5 alucina mais que o anterior?
Sim. A taxa de alucinação está em 50%, sete pontos percentuais acima do Opus 4.8. Ele acerta mais e chuta mais ao mesmo tempo. Para trabalho que depende de exatidão factual, continue exigindo citação de fonte e verificação humana.
Como acessar o Claude Opus 5?
Ele está disponível em todas as plataformas da Anthropic desde 24 de julho de 2026, como modelo padrão do Claude Max e o mais forte disponível no Claude Pro. Na API, o identificador é claude-opus-5.
Próximo passo
Se o que você precisa é escolher um modelo pra colocar pra trabalhar num problema real, comece pelo comparativo de IA para programar. Se o problema é decidir onde a IA entra no seu processo antes de escolher a ferramenta, o guia de IA para empresas cobre a ordem certa.
E se você quer discutir um caso concreto, com números do seu negócio, fale com a gente pelo WhatsApp. Sem apresentação comercial de 40 slides.
Atualizado em julho de 2026. Benchmarks conferidos contra o anúncio oficial da Anthropic, a Artificial Analysis, a Vals.ai e a Epoch AI. Autor: Guilherme Fernandes, fundador da Huios Web (Pelotas/RS), +250 projetos entregues desde 2023 em 83 cidades.
Publicado em 27 de julho de 2026 · Por Equipe Huios