O Google lançou em 21 de julho de 2026 o Gemini 3.6 Flash, o 3.5 Flash-Lite e o 3.5 Flash Cyber. O 3.6 Flash custa US$ 1,50 por milhão de tokens de entrada e US$ 7,50 na saída, queda de US$ 9,00 na geração anterior, e usa 17% menos tokens para responder. O que não veio foi o Gemini 3.5 Pro, atrasado há mais de dois meses.
Vale ler o anúncio pelo que ele não diz. O Google entregou três modelos do degrau barato enquanto o carro-chefe segue preso em treinamento. Para a corrida de manchetes isso é derrota. Para uma empresa brasileira pagando conta de API todo mês, é o lançamento mais relevante do trimestre, e explicamos por quê. A Huios usa modelos dos quatro laboratórios em produção e compara todos pelo mesmo critério no comparativo de IA para programar.
O tier Flash é o que decide a conta
Existe uma confusão comum entre acompanhar IA e comprar IA.
Quem acompanha olha o topo: qual modelo ganhou o benchmark desta semana. Quem compra olha o meio da tabela, porque é ali que 90% do volume roda. Classificar mensagem, extrair campo de nota fiscal, resumir chamado, traduzir descrição de produto. Tarefa simples, repetida milhares de vezes por dia.
Nesse volume, a diferença entre US$ 7,50 e US$ 25 por milhão de tokens de saída não é detalhe de planilha. É a diferença entre o projeto fechar a conta e não fechar.
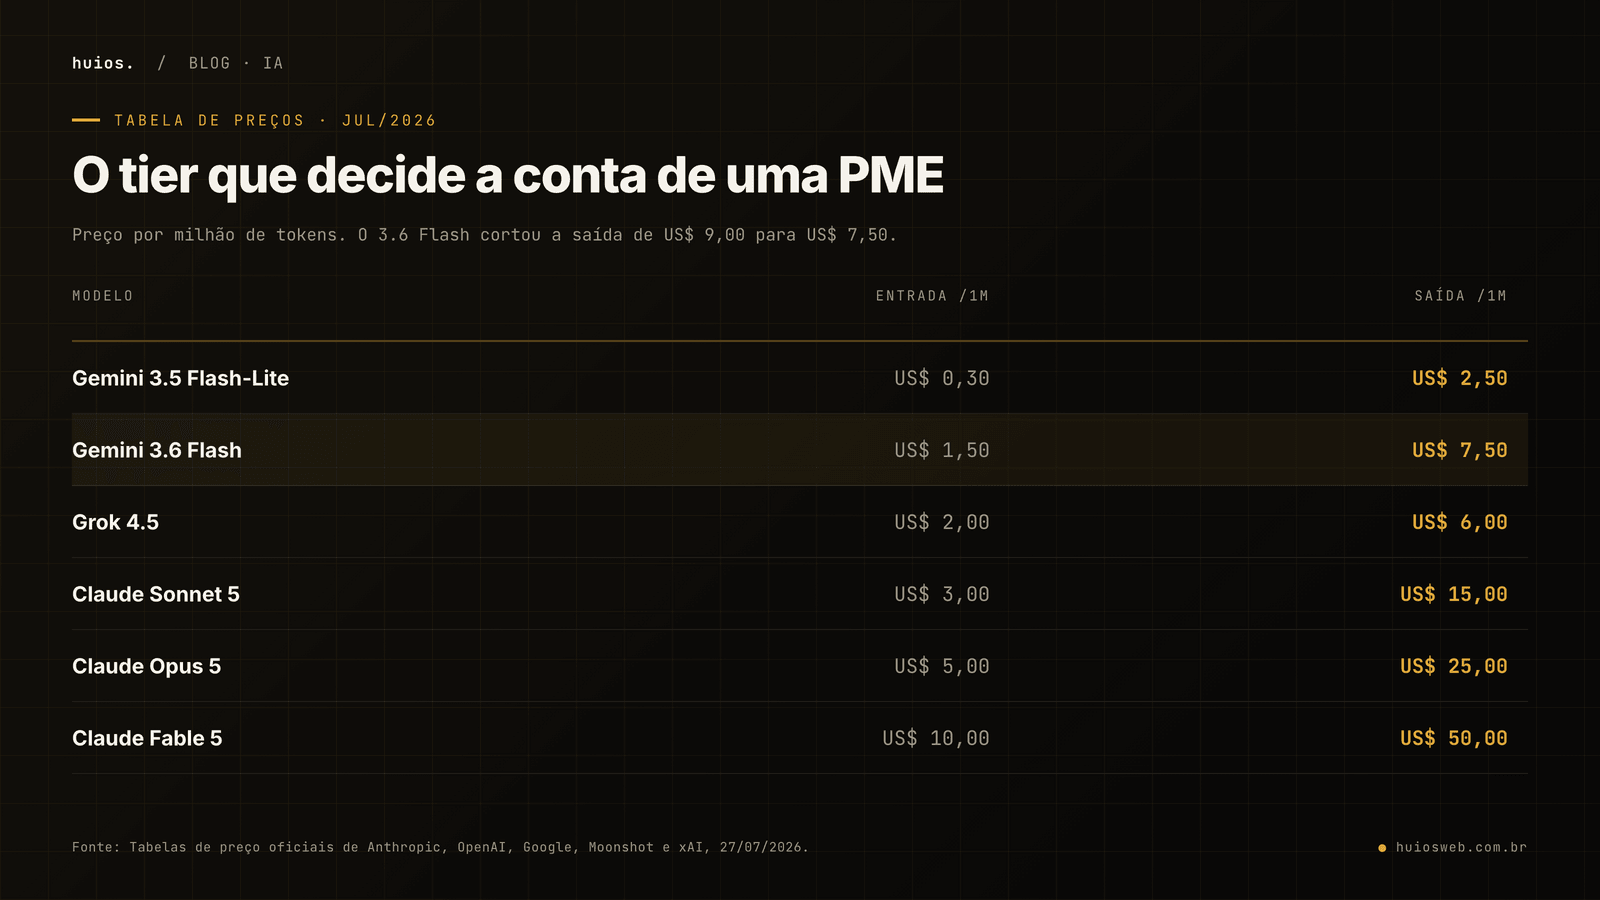
| Modelo | Entrada /1M | Saída /1M |
|---|---|---|
| Gemini 3.5 Flash-Lite | US$ 0,30 | US$ 2,50 |
| Gemini 3.6 Flash | US$ 1,50 | US$ 7,50 |
| Grok 4.5 | US$ 2,00 | US$ 6,00 |
| Claude Sonnet 5 | US$ 3,00 | US$ 15,00 |
| Claude Opus 5 | US$ 5,00 | US$ 25,00 |
| Claude Fable 5 | US$ 10,00 | US$ 50,00 |
O corte na saída, de US$ 9,00 para US$ 7,50, é só metade da economia. A outra metade é que o modelo fala menos: 17% menos tokens de saída no índice da Artificial Analysis, e até 65% menos em testes específicos do DeepSWE. Cobrar menos por token e gastar menos tokens compõe.
Melhor em tudo que o antecessor
O Google publicou a comparação direta contra o 3.5 Flash e ela é consistente.
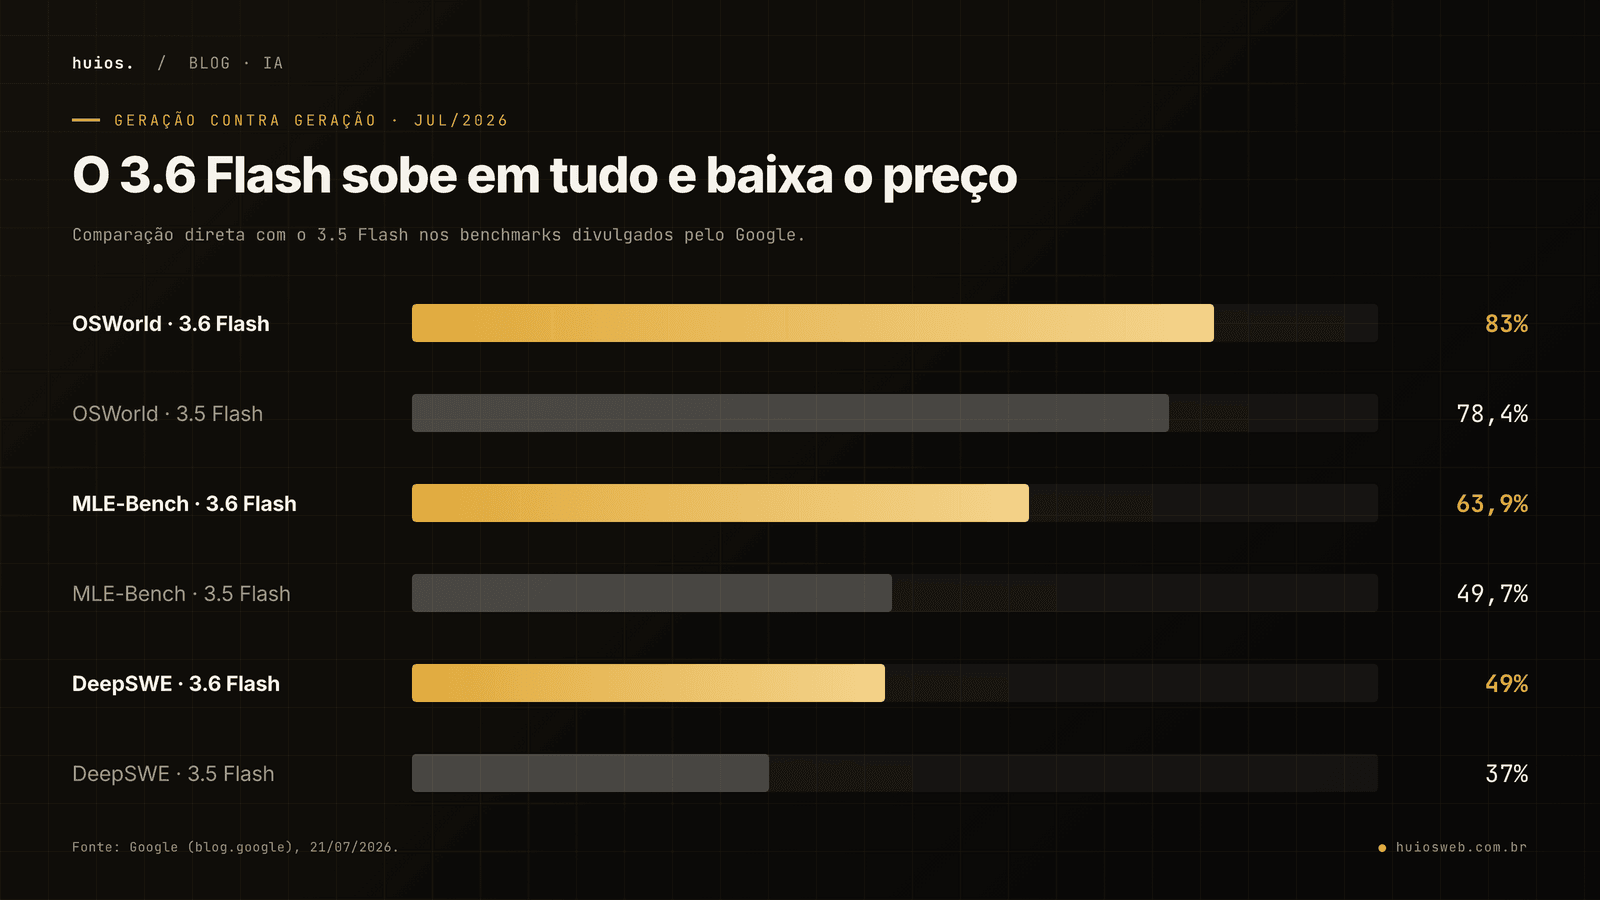
| Benchmark | 3.6 Flash | 3.5 Flash |
|---|---|---|
| OSWorld-Verified | 83% | 78,4% |
| MLE-Bench | 63,9% | 49,7% |
| DeepSWE | 49% | 37% |
| GDPval-AA v2 | 1421 | 1349 |
Doze pontos de ganho no DeepSWE e catorze no MLE-Bench, com preço menor. É a mesma jogada que a Anthropic fez três dias depois com o Claude Opus 5: manter ou baixar o preço e subir o resultado, transferindo a competição do "quem é mais inteligente" para "quem custa menos por tarefa concluída".
Clientes citados pelo Google no anúncio incluem Figma, Harvey, Hebbia e JetBrains, com casos de leitura de documento, análise de gráfico e migração de código.
Há um efeito colateral raramente comentado quando um modelo passa a gastar menos tokens para responder: além de baratear, ele encurta a espera. Menos tokens gerados significa menos tempo até a última palavra chegar, e num fluxo com várias etapas encadeadas essa economia se acumula a cada passo. Quem monta assistente que consulta banco, valida regra e devolve resposta na tela sente a diferença antes de ver a fatura.
O Flash-Lite passa o modelo grande da geração anterior
Esse é o dado mais estranho do lançamento, e o mais útil.
O 3.5 Flash-Lite fica no degrau mais barato que o Google vende: US$ 0,30 na entrada e US$ 2,50 na saída. Roda a cerca de 350 tokens por segundo, o mais rápido da série. E, em vários testes, ele bate o Gemini 3 Flash, um modelo maior e mais caro da geração anterior.
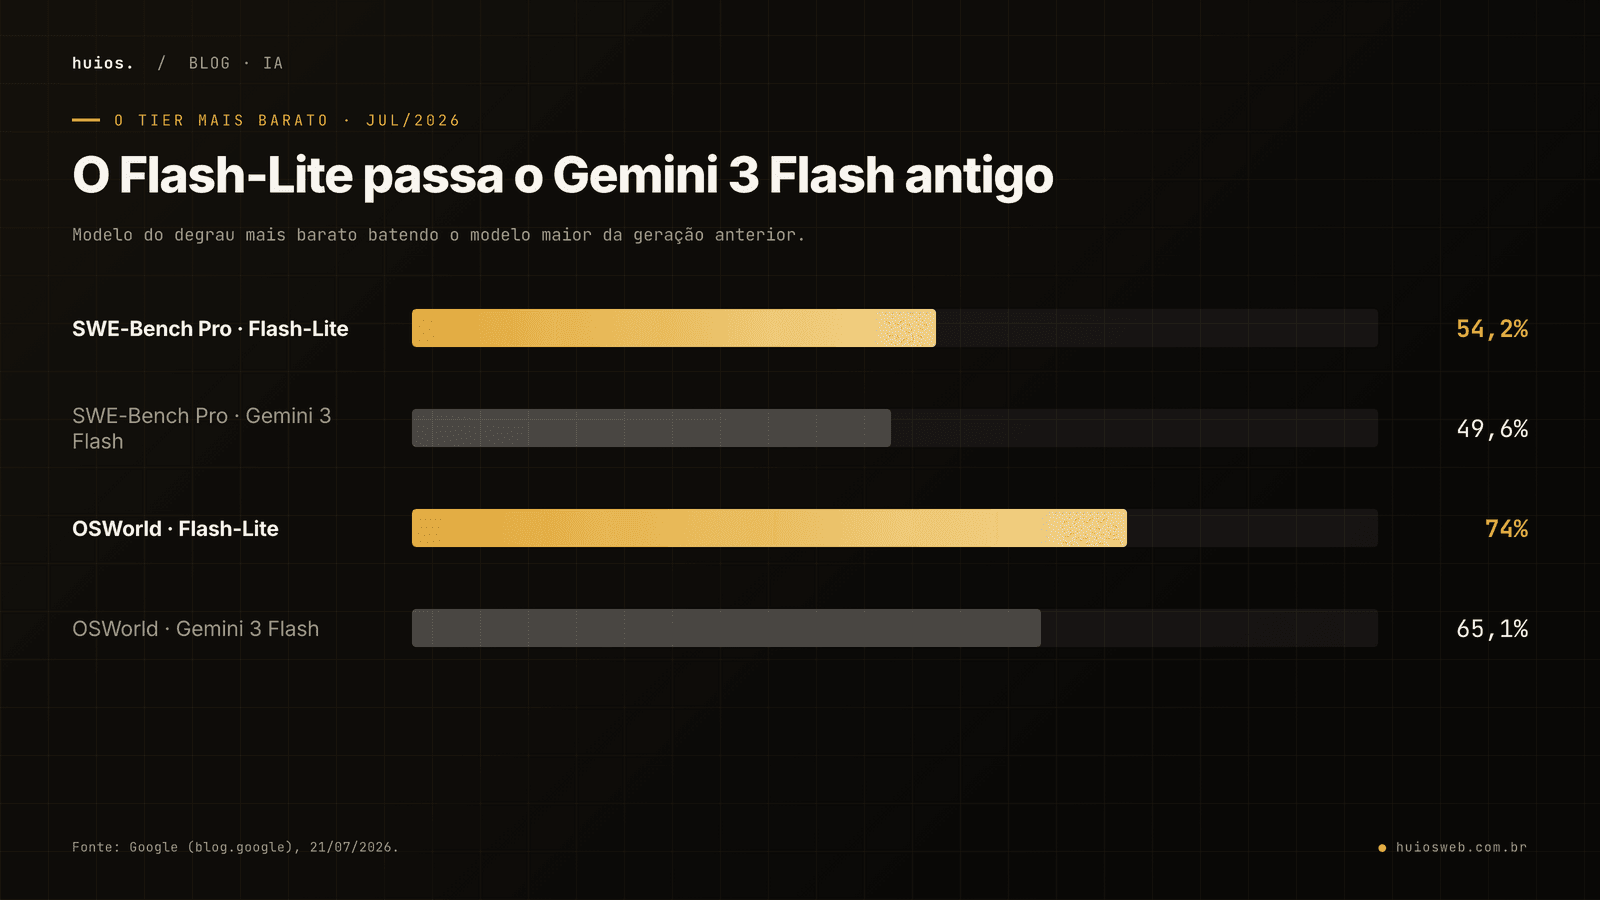
| Benchmark | 3.5 Flash-Lite | Gemini 3 Flash |
|---|---|---|
| SWE-Bench Pro | 54,2% | 49,6% |
| OSWorld-Verified | 74,0% | 65,1% |
| Terminal-Bench 2.1 | 54% | 31%¹ |
| GDM-MRCR v2 | 72,2% | 60,1%¹ |
¹ Comparação contra o 3.1 Flash-Lite, não contra o 3 Flash.
A implicação prática: se você tem carga rodando no Gemini 3 Flash hoje, provavelmente dá pra descer um degrau, ficar mais rápido e pagar menos. Vale medir antes de migrar, mas o dado sugere que sim.
O Flash Cyber e o que ele revela
O terceiro modelo do anúncio não está à venda.
O 3.5 Flash Cyber é ajustado para encontrar e corrigir vulnerabilidade de software. Roda apenas dentro do CodeMender, o agente de segurança de código do DeepMind, e o acesso é limitado a governos e parceiros de confiança. No benchmark CyberGym ele marca 83,2%, a menos de dois pontos do GPT-5.5-Cyber (85,6%), apesar de ser um modelo bem menor.
Vários agentes Flash Cyber trabalham em paralelo varrendo trechos diferentes de código e depois juntam os achados num relatório só.
A parte interessante é a política: o Google decidiu não vender capacidade ofensiva de cibersegurança no varejo. A Anthropic fez movimento parecido ao tirar treino ofensivo do Opus 5 de propósito. E, no mesmo mês, a OpenAI descobriu na prática por que essa cautela existe, no episódio que descrevemos em agentes de IA em produção.
O elefante: cadê o Gemini 3.5 Pro?
Anunciado no Google I/O em maio de 2026, o 3.5 Pro passou de mais de dois meses do prazo prometido e continua fora do ar. Enquanto isso, a OpenAI lançou o GPT-5.6, a Anthropic lançou Fable 5, Sonnet 5 e Opus 5, e a Moonshot lançou o Kimi K3.
Cada semana de atraso move o alvo: o 3.5 Pro precisa nascer melhor do que precisaria em maio. É um problema real para o Google e não muda nada para você agora. O que existe hoje é a linha Flash, e ela está competitiva no lugar onde a maior parte do volume roda.
Se a sua comparação é entre assistentes de uso geral, e não entre APIs, o recorte está em Gemini contra ChatGPT e no comparativo dos três grandes.
Uma conta real de leitura de documento
Preço de tabela não convence ninguém sozinho. Vale simular um caso comum aqui na agência: extrair dados estruturados de nota fiscal e boleto para alimentar um financeiro.
Suponha 30 mil documentos por mês. Cada página convertida em texto ocupa cerca de 1.800 tokens de entrada, e o retorno em JSON, com campos como fornecedor, vencimento, valor e centro de custo, gasta perto de 250 tokens.
Mensalmente são 54 milhões de tokens de entrada e 7,5 milhões de saída. No Gemini 3.6 Flash, a entrada custa US$ 81 e a saída US$ 56,25, totalizando aproximadamente US$ 137. No Flash-Lite, os mesmos volumes caem para US$ 16,20 e US$ 18,75, algo perto de US$ 35. Convertendo a US$ 1 = R$ 5,15, a diferença anual entre os dois degraus passa de R$ 6,3 mil.
Para extração de campo com formato previsível, o degrau barato costuma bastar. A decisão correta raramente é escolher um modelo único: é rotear. Documento limpo e padronizado vai para o Flash-Lite; documento manuscrito, rasurado ou fotografado torto sobe para o 3.6 Flash; o que falhar duas vezes vai para revisão humana.
Esse desenho de roteamento derruba a fatura sem derrubar a qualidade, e é justamente o tipo de arquitetura que o preço agressivo da linha Flash viabiliza. Antes de escolher, meça a taxa de acerto de cada degrau numa amostra rotulada de uns 200 documentos seus. A amostra custa uma tarde e evita meses pagando por capacidade que sua carga não exigia.
Uma ressalva importante sobre latência: velocidade alta ajuda em interface onde alguém espera resposta na tela, e é indiferente num processamento noturno em lote. Escolher o modelo mais rápido para trabalho assíncrono é pagar por um atributo que ninguém no processo vai perceber.
Quando não usar o Gemini 3.6 Flash
Ele não é modelo de fronteira e não finge ser. Para refatoração grande, depuração difícil e análise de causa raiz, os modelos do topo resolvem em menos tentativas, e menos tentativas costuma sair mais barato mesmo com token mais caro.
Também não use se o seu volume é baixo. Se você gasta R$ 200 por mês em API, economizar 40% dá R$ 80, e não paga o dia de trabalho de migrar e revalidar tudo. Otimização de custo só compensa quando o custo é grande.
E não use o Flash Cyber como argumento de venda: ele não está disponível para empresas comuns, ponto.
Onde ele brilha: pipeline de alto volume com tarefa bem definida, agente que faz muitas chamadas curtas, processamento de documento em escala. É exatamente o tipo de carga que aparece em projeto de desenvolvimento de sistemas.
Perguntas frequentes
Quanto custa o Gemini 3.6 Flash?
US$ 1,50 por milhão de tokens de entrada e US$ 7,50 por milhão na saída. O preço de saída caiu de US$ 9,00 na geração anterior. O Gemini 3.5 Flash-Lite, do degrau mais barato, custa US$ 0,30 na entrada e US$ 2,50 na saída.
Qual a diferença entre Gemini 3.6 Flash e 3.5 Flash-Lite?
O 3.6 Flash é mais capaz e mais caro, voltado para trabalho agêntico e código. O Flash-Lite é o degrau mais barato e mais rápido, a cerca de 350 tokens por segundo, mas supera o Gemini 3 Flash da geração anterior em SWE-Bench Pro e OSWorld-Verified, o que o torna competitivo para volume alto.
O que é o Gemini 3.5 Flash Cyber?
É um modelo especializado em encontrar e corrigir vulnerabilidades de software, que roda apenas dentro do CodeMender, o agente de segurança do Google DeepMind. Não está disponível na API pública: o acesso é limitado a governos e parceiros de confiança num piloto restrito.
O Gemini 3.5 Pro foi lançado?
Não. Foi anunciado no Google I/O de maio de 2026 e segue atrasado há mais de dois meses, sem data confirmada. O lançamento de 21 de julho trouxe apenas modelos do tier Flash.
Vale trocar do Gemini 3 Flash para o 3.5 Flash-Lite?
Provavelmente sim, se o seu caso for volume alto de tarefa simples. O Flash-Lite marca 54,2% no SWE-Bench Pro contra 49,6% do Gemini 3 Flash e 74,0% no OSWorld-Verified contra 65,1%, custando menos e rodando mais rápido. Meça na sua carga antes de migrar tudo.
Próximo passo
Para escolher entre os modelos de todos os laboratórios, com custo por tarefa lado a lado, vá para o comparativo de IA para programar. Para entender o movimento de preço que o Google respondeu, leia sobre o Claude Opus 5 e sobre o Kimi K3.
Tem um pipeline de alto volume e quer saber quanto custaria rodá-lo com modelo certo? Fale com a gente pelo WhatsApp.
Atualizado em julho de 2026. Números conferidos contra o anúncio do Google (blog.google e deepmind.google), a Artificial Analysis e a cobertura da TechCrunch. Autor: Guilherme Fernandes, fundador da Huios Web (Pelotas/RS), +250 projetos entregues desde 2023 em 83 cidades.
Publicado em 27 de julho de 2026 · Por Equipe Huios