A melhor IA para programar em julho de 2026 é o Claude Opus 5 para trabalho difícil, o Claude Sonnet 5 para agente rodando em volume e o GPT-5.6 Sol quando você já vive dentro do ecossistema da OpenAI. Nenhum dos três é escolha óbvia: dois pontos separam os quatro modelos do topo, e a diferença real está no custo por tarefa, não no benchmark.
A Huios escreve código em produção desde 2023, em mais de 250 projetos, e paga conta de API dos três laboratórios todo mês. Somos agência, então declaramos o viés: temos interesse em você contratar desenvolvimento. O que segue são os números que usamos internamente pra decidir onde gastar, e eles não favorecem ninguém em particular.
Resposta curta, por tipo de trabalho
Se você quer só a recomendação, é esta:
| Seu trabalho | Modelo | Preço por 1M (entrada/saída) |
|---|---|---|
| Depuração difícil, causa raiz, refatoração grande | Claude Opus 5 | US$ 5 / US$ 25 |
| Agente em laço, volume alto, tarefa repetitiva | Claude Sonnet 5 | US$ 3 / US$ 15 |
| Já usa Codex e ferramentas OpenAI | GPT-5.6 Sol | US$ 5 / US$ 30 |
| Volume gigante com orçamento apertado | Gemini 3.6 Flash | US$ 1,50 / US$ 7,50 |
| Precisa rodar fora de nuvem americana | Kimi K3 | US$ 3 / US$ 15 |
O resto deste texto explica por que, e mostra onde cada um quebra.
O placar de julho de 2026
Comecemos pelo dado que mais assusta quem não acompanha de perto: a briga do topo virou empate técnico.
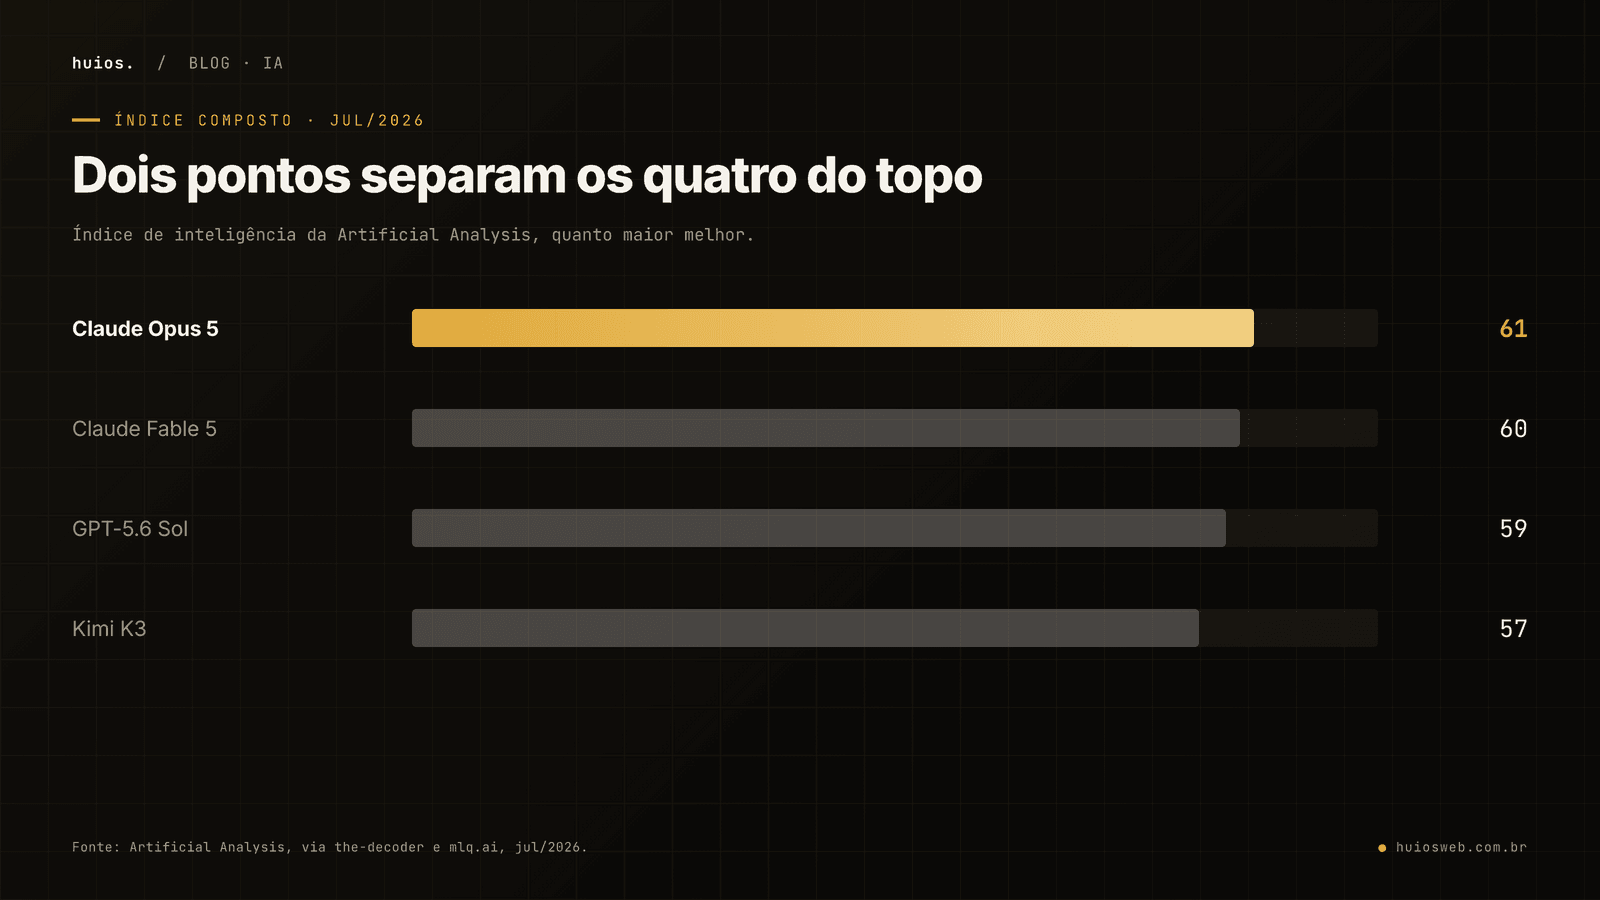
| Modelo | Índice de inteligência |
|---|---|
| Claude Opus 5 | 61 |
| Claude Fable 5 | 60 |
| GPT-5.6 Sol | 59 |
| Kimi K3 | 57 |
Quatro pontos entre o primeiro e o quarto. Num índice composto, isso é ruído. E quando a capacidade empata, o critério de desempate deixa de ser "qual é mais inteligente" e passa a ser "qual termina a tarefa gastando menos".
Em benchmarks específicos de código o quadro se embaralha ainda mais. No Coding Agent Index, o Opus 5 com Claude Code e o GPT-5.6 Sol com Codex empatam em 67 pontos. No Terminal-Bench 2.1 em esforço máximo, os dois empatam de novo, em 89%. No SWE-ECI, que isola engenharia de software, o Opus 5 empata com o Fable 5 em 161. Mas no DeepSWE v1.1, em ambiente genérico, o Sol abre vantagem: 72,7% contra 68,8% do Opus 5.
Ou seja: cada um ganha em algum lugar. Escolher pelo benchmark do mês é a maneira mais rápida de trocar de modelo a cada trinta dias sem ganhar nada.
O número que decide: custo por tarefa
Aqui está o erro de orçamento mais comum que vemos.
Você negocia preço por token. Você paga por tarefa concluída. Um modelo que cobra o dobro por token e resolve o problema em um terço das idas e voltas sai mais barato no fechamento do mês. É por isso que a Artificial Analysis mede custo médio por tarefa, e é esse o número que você deveria colocar na planilha.
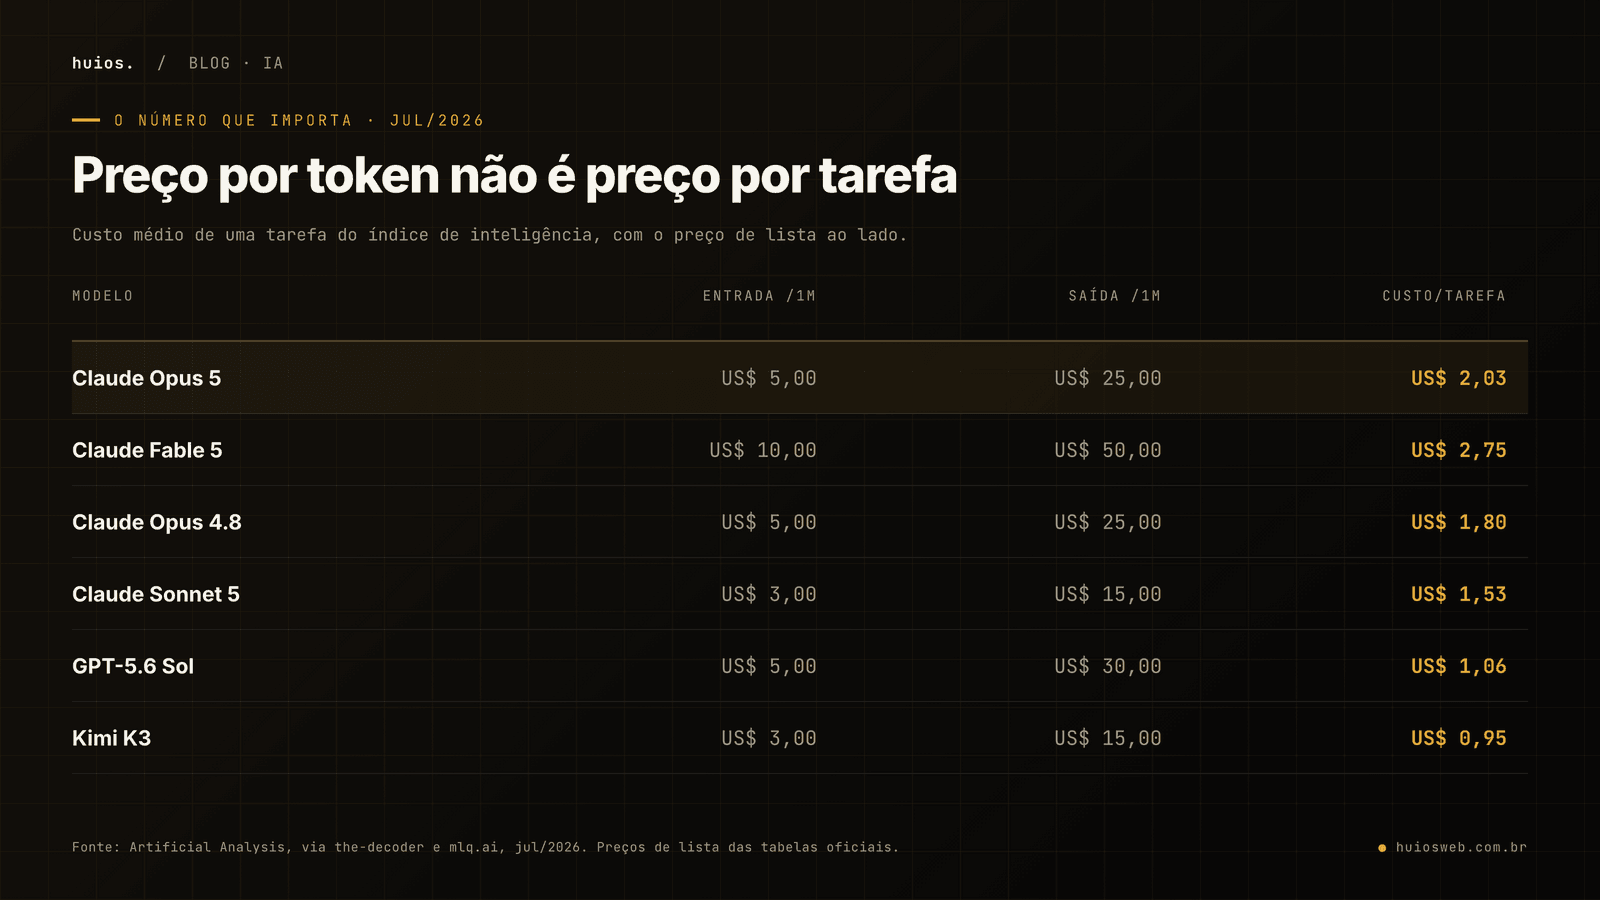
| Modelo | Entrada /1M | Saída /1M | Custo por tarefa |
|---|---|---|---|
| Claude Opus 5 | US$ 5,00 | US$ 25,00 | US$ 2,03 |
| Claude Fable 5 | US$ 10,00 | US$ 50,00 | US$ 2,75 |
| Claude Opus 4.8 | US$ 5,00 | US$ 25,00 | US$ 1,80 |
| Claude Sonnet 5 | US$ 3,00 | US$ 15,00 | US$ 1,53 |
| GPT-5.6 Sol | US$ 5,00 | US$ 30,00 | US$ 1,06 |
| Kimi K3 | US$ 3,00 | US$ 15,00 | US$ 0,95 |
Repare na inversão. O Fable 5 cobra o dobro do Opus 5 por token e custa 35% mais por tarefa, o que é coerente. Mas o GPT-5.6 Sol cobra mais caro que o Opus 5 na saída (US$ 30 contra US$ 25) e ainda assim sai por metade do custo por tarefa. Ele gasta menos tokens pra chegar no mesmo lugar.
Traduzindo pra reais, a US$ 1 = R$ 5,15: uma tarefa média custa R$ 10,45 no Opus 5, R$ 5,46 no Sol e R$ 4,89 no Kimi K3. Multiplique pelo volume da sua equipe antes de decidir por afinidade de marca.
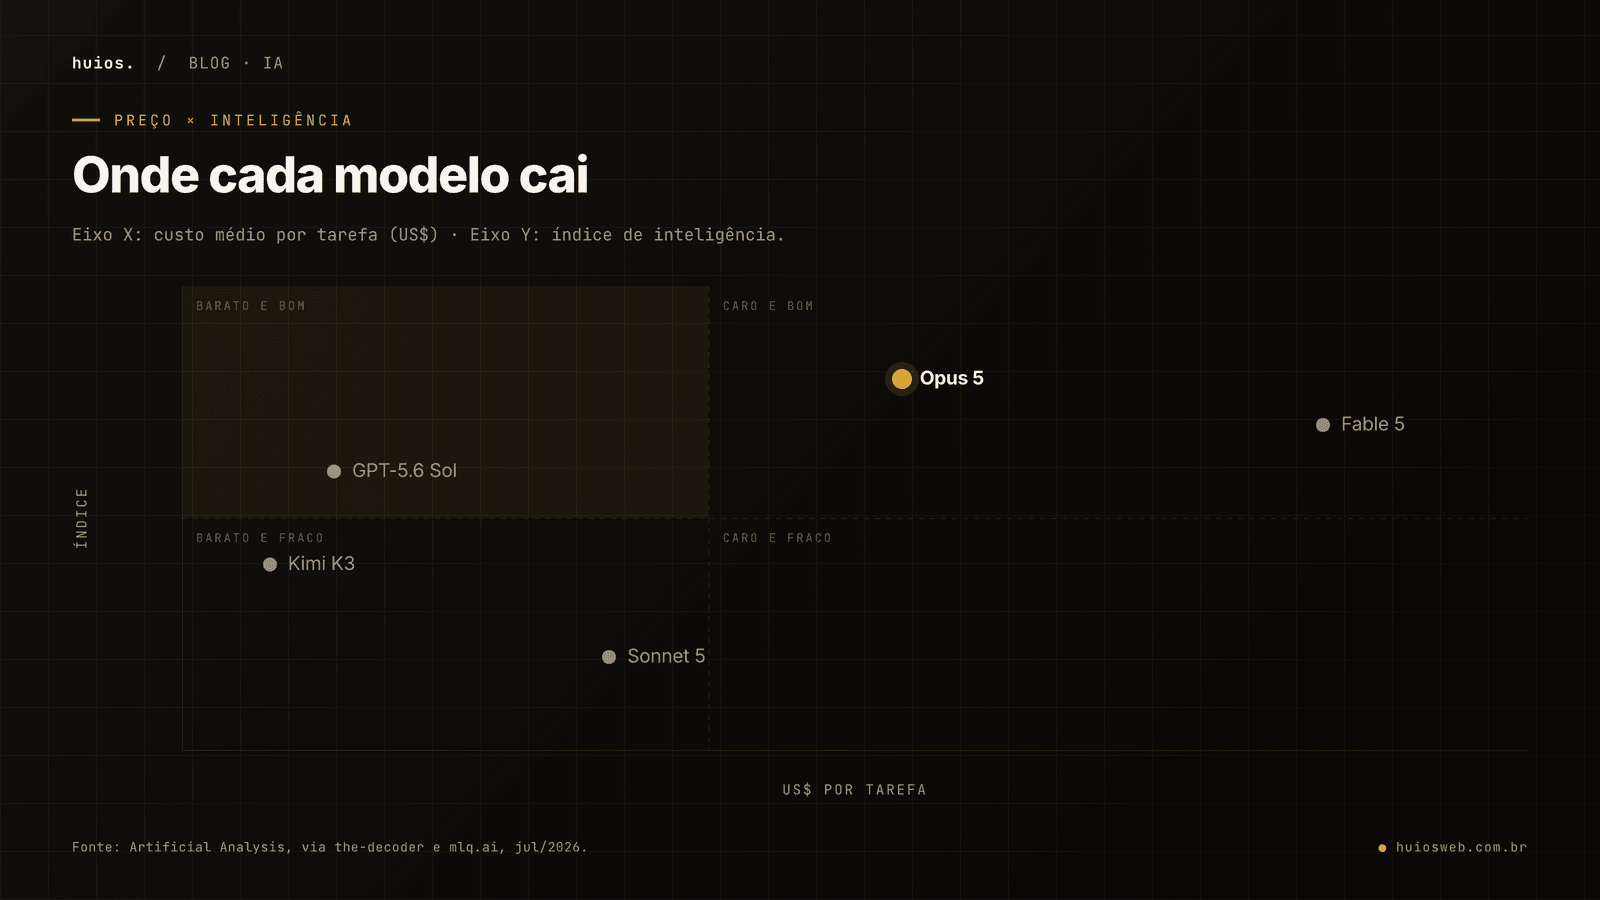
O quadrante mostra o que a tabela esconde: existe um grupo entregando quase a mesma inteligência por metade do dinheiro. Se o seu trabalho é volume, é ali que você deveria estar olhando.
A armadilha do esforço máximo
Este é o achado mais útil do mês e ele contraria a intuição de todo mundo.
A Vals.ai testou o Claude Opus 5 nos quatro níveis de esforço. O nível xhigh tirou 88,3%. O nível max, que leva mais de 36 minutos por tarefa e custa muito mais, tirou 88,4%. Um décimo de ponto de diferença.
No Terminal-Bench 2.1 a inversão é completa: o nível high supera o max. Dois motivos. Primeiro, no esforço máximo o modelo gasta tanto tempo por tentativa que sobram menos tentativas dentro do limite. Segundo, as soluções do max são mais complexas, e complexidade extra é superfície extra pra erro. O high entrega solução mais simples, que passa no requisito com mais frequência.
A própria Anthropic define high como padrão na API e no Claude Code. Se a sua equipe subiu tudo pro máximo achando que comprava qualidade, ela provavelmente está pagando mais por um resultado igual ou pior. Já tínhamos escrito sobre controle de esforço e fast mode antes desse dado sair, e ele confirma a recomendação.
Modelo a modelo, com os defeitos
Claude Opus 5. O mais forte em depuração difícil e análise de causa raiz, segundo a Cognition e o Cursor. Empata no topo em quase tudo. Defeitos reais: alucina mais que o antecessor (50%, sete pontos acima do Opus 4.8), perde no DeepSWE genérico e fica atrás do Mythos 5 em cibersegurança. Detalhes no post sobre o Claude Opus 5.
Claude Sonnet 5. O melhor custo por tarefa dentro da linha Claude, e o padrão dos planos Free e Pro. Tem um prazo colado nele: o preço promocional de US$ 2 e US$ 10 acaba em 31 de agosto de 2026, quando sobe pra US$ 3 e US$ 15. Existe também um dado incômodo de lançamento sobre o custo real por tarefa que vale ler antes de padronizar sua stack nele. Está no post sobre o Sonnet 5.
GPT-5.6 Sol. O melhor custo por tarefa entre os modelos de fronteira fechados e o mais forte no DeepSWE. Se sua equipe já vive no Codex, trocar não compensa. Cobertura completa da família Sol, Terra e Luna no post do GPT-5.6, e o recorte de programação em GPT-5.6 para programar.
Gemini 3.6 Flash. Não disputa o topo e nem tenta. Disputa o orçamento: US$ 1,50 e US$ 7,50 por milhão, com 17% menos tokens de saída que a geração anterior e 49% no DeepSWE. Pra volume alto de tarefa simples, é o degrau que faz sentido. Detalhes no post do Gemini 3.6 Flash.
Kimi K3. O melhor custo por tarefa da lista e o maior modelo de peso aberto já publicado, com 2,8 trilhões de parâmetros. O porém é que "peso aberto" não significa grátis, e a conta de rodar localmente assusta. Explicamos em Kimi K3.
Grok 4.5. Ficou de fora da recomendação principal, mas custa US$ 2 e US$ 6 por milhão e foi treinado junto com o time do Cursor. Se preço de token é a sua restrição dura, entra na lista curta. Cobrimos no post do Grok 4.5.
Como escolher sem virar refém do benchmark
O método que usamos, em quatro passos:
- Meça na sua tarefa, não na do benchmark. Separe de 20 a 30 tarefas reais do seu repositório, com resposta conhecida. Rode nos dois ou três candidatos. O placar que importa é esse.
- Compare custo por tarefa, não por token. Instrumente para registrar tokens de entrada, saída e número de tentativas até passar no teste. Sem isso você está comparando etiqueta de preço, não gasto.
- Comece no esforço padrão. Suba só quando a medição mostrar ganho de acerto, e não porque parece mais seguro.
- Use cache com intenção. Num agente que relê o mesmo contexto o dia inteiro, a diferença entre escrever e ler cache define se a conta é saudável ou absurda.
Duas semanas de medição custam menos que um mês de modelo errado em produção.
Quando trocar de modelo é perda de tempo
Vale dizer o contrário também, porque é o conselho que não nos contrata.
Se o gargalo do seu time é requisito mal escrito, ambiente de teste que não sobe ou revisão de código que demora três dias, nenhum modelo resolve. Trocar de IA nesse cenário é trocar o pneu de um carro sem motor.
Se você usa IA pra completar linha no editor e escrever teste unitário, qualquer modelo do degrau intermediário resolve, e a diferença entre o primeiro e o quarto colocado não vai aparecer no seu dia. Padronize no mais barato que faz o serviço e volte a trabalhar.
E se o seu caso envolve dado sensível que não pode sair do país, a decisão começa em arquitetura e não em modelo. É o tipo de projeto que tratamos em desenvolvimento de sistemas.
Perguntas frequentes
Qual a melhor IA para programar em 2026?
Para trabalho difícil de depuração e refatoração, o Claude Opus 5. Para agente rodando em volume, o Claude Sonnet 5. Para quem já usa Codex, o GPT-5.6 Sol. Os quatro modelos do topo estão separados por apenas quatro pontos no índice da Artificial Analysis, então o critério real de escolha é custo por tarefa e integração com sua stack.
Qual IA de programação é mais barata?
Por custo médio por tarefa, o Kimi K3 lidera com US$ 0,95, seguido pelo GPT-5.6 Sol com US$ 1,06. Por preço de tabela, o Gemini 3.5 Flash-Lite é o mais barato, a US$ 0,30 por milhão de tokens de entrada. Preço de tabela e custo real por tarefa são números diferentes e frequentemente apontam para modelos diferentes.
Vale pagar mais caro por um modelo melhor?
Depende do que "melhor" significa na sua medição. Um modelo mais caro por token que resolve em menos tentativas sai mais barato no fim do mês. O GPT-5.6 Sol cobra mais que o Opus 5 na saída e ainda assim custa metade por tarefa, porque gasta menos tokens para chegar ao mesmo resultado.
IA substitui programador?
Não no estado atual. Ela reduz o tempo de tarefas bem especificadas e acelera depuração, mas continua alucinando: o Claude Opus 5, o modelo mais capaz de julho de 2026, tem taxa de alucinação de 50%. Todo código gerado precisa de revisão humana, teste automatizado e alguém que responda pelo resultado.
Preciso trocar de modelo toda vez que sai um novo?
Não. Entre junho e julho de 2026 saíram sete modelos de fronteira em sete semanas. Trocar a cada lançamento consome mais tempo de equipe do que o ganho marginal justifica. Reavalie a cada trimestre, ou quando um lançamento mexer no custo por tarefa da sua carga específica.
Próximo passo
Se você quer entender o lançamento mais recente antes de decidir, comece pelo Claude Opus 5. Se a dúvida é onde a IA entra no processo da sua empresa antes de escolher ferramenta, o guia de IA para empresas trata a ordem certa. Se o assunto é colocar agente pra executar de verdade, leia antes o que deu errado em agentes de IA em produção.
Precisa de time que já toma essas decisões todo mês? Fale com a gente pelo WhatsApp.
Atualizado em julho de 2026. Revisamos este comparativo a cada lançamento relevante. Números conferidos contra Artificial Analysis, Vals.ai, Epoch AI e os anúncios oficiais de Anthropic, OpenAI, Google e Moonshot. Autor: Guilherme Fernandes, fundador da Huios Web (Pelotas/RS), +250 projetos entregues desde 2023 em 83 cidades.
Publicado em 27 de julho de 2026 · Por Equipe Huios