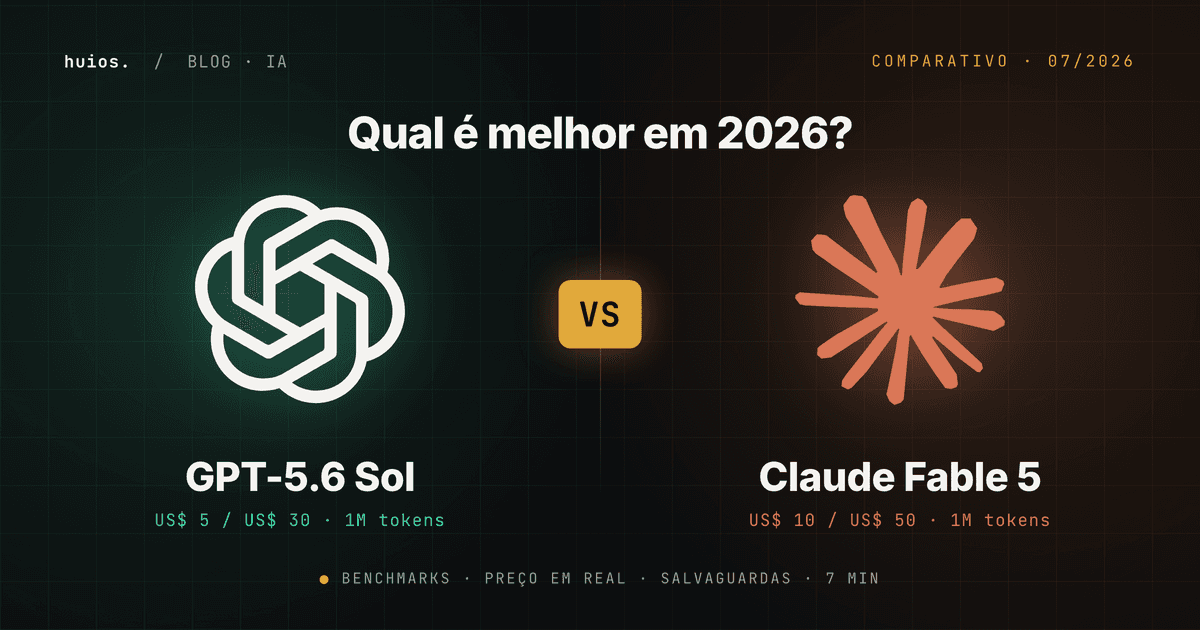
Resposta curta: escolha o GPT-5.6 Sol se o seu trabalho é agêntico e sensível a custo — ele lidera o Terminal-Bench 2.1 e custa metade do preço. Escolha o Claude Fable 5 se você já vive no ecossistema Claude e depende de tarefa longa com memória persistente, onde os relatos de uso real ainda pesam a favor da Anthropic. Os dois saíram com menos de um mês de diferença e são, hoje, os modelos públicos mais capazes dos dois lados.
A Huios usa Claude, ChatGPT e Gemini em produção pra clientes diferentes. Sem afiliação com nenhum dos dois lados — e conflito de interesse declarado: a gente vende consultoria de IA aplicada. Cada benchmark abaixo vem do material de divulgação de uma das empresas; está marcado de quem.
Cobrimos o lançamento do Fable 5 no dia 9 de junho e o do GPT-5.6 agora em julho. Este post cruza os dois. Uma ressalva de cronologia importa: o Fable 5 tem um mês de uso público acumulado; o GPT-5.6 está saindo do preview restrito agora — os números dele têm menos quilometragem.
A tabela executiva
| GPT-5.6 Sol | Claude Fable 5 | |
|---|---|---|
| Lançamento | 26/06/2026 (preview) → GA em julho | 09/06/2026 |
| Preço API (1M tokens) | US$ 5 entrada / US$ 30 saída | US$ 10 / US$ 50 |
| Em real (~R$ 5,15) | ≈ R$ 26 / R$ 155 | ≈ R$ 52 / R$ 258 |
| Terminal-Bench 2.1 | 88,8% (Ultra: 91,9%) — material OpenAI | 84,3% — mesmo material |
| Salvaguarda | Classifiers pausam a geração pra revisão | Classifiers redirecionam pro Opus 4.8 (fallback transparente) |
| Tiers na família | Sol / Terra / Luna | Fable 5 único (Mythos 5 restrito) |
| Disponibilidade | GA prevista pra semana de 08/07 | Público desde 09/06 (créditos de uso desde 23/06) |
Preço: a diferença que não precisa de benchmark
Comece pelo número que não depende de harness de teste: o Sol custa exatamente metade do Fable 5, tanto na entrada quanto na saída. Num agente que consome 10 milhões de tokens de saída por mês, a diferença é US$ 200 mensais — só de saída, só num agente.
E a família GPT-5.6 desce mais dois degraus que a Anthropic não oferece nessa geração: o Terra (US$ 2,50/US$ 15) entrega nível GPT-5.5, e o Luna (US$ 1/US$ 6) atende tarefa rotineira por um décimo do custo do Fable 5. Do lado da Anthropic, abaixo do Fable 5 o degrau é o Opus 4.8 (US$ 5/US$ 25) — que compete em preço com o Sol, não com o Terra.
O cache também mudou de lado: o GPT-5.6 introduziu vida mínima de 30 minutos com breakpoints explícitos, enquanto o cache da Anthropic segue com TTL padrão de 5 minutos (o de 1 hora custa extra). Pra agente de longa duração, é vantagem operacional real da OpenAI.
Benchmarks: cada um mede no próprio quintal
No Terminal-Bench 2.1 — o benchmark que a OpenAI escolheu como vitrine — o placar do anúncio dá Sol Ultra 91,9%, Sol 88,8%, e o Fable 5 em 84,3%, empatado com o Terra. Ou seja: pelo material da OpenAI, o tier intermediário dela empata com o flagship da concorrente custando um quarto do preço.
Agora, a ressalva que a gente repete em todo post de lançamento: empresa nenhuma publica benchmark em que perde. A Anthropic apresentou o Fable 5 como state-of-the-art "em quase todos os benchmarks" no dia 9 de junho — citando FrontierCode (Cognition), CursorBench e os relatos de parceiro, como a migração de 50 milhões de linhas da Stripe em 1 dia. A OpenAI respondeu com Terminal-Bench, GeneBench e ExploitBench. Não existe medição independente cruzando os dois ainda; o GPT-5.6 nem chegou à disponibilidade geral.
O que dá pra afirmar sem torcer o dado: os dois são a fronteira pública de julho de 2026, a distância entre eles é pequena o bastante pra depender do tipo de tarefa, e a diferença de preço é grande o bastante pra não depender de nada.
Salvaguardas: pausa vs rebaixamento
Os dois lançamentos inauguraram a era do modelo vigiado — e resolveram o problema de jeitos diferentes.
O Fable 5 usa classifiers de cibersegurança, biologia/química e destilação que, quando acionados, redirecionam a resposta pro Claude Opus 4.8 e avisam o usuário. Não é recusa: é rebaixamento transparente pro segundo melhor modelo da casa. Mais de 95% das sessões não acionam trava nenhuma, segundo a Anthropic. O efeito colateral: tráfego Mythos-class tem retenção obrigatória de 30 dias, inclusive via terceiros.
O GPT-5.6 usa classifiers de cyber e biologia que leem a saída em tempo real e podem pausar a geração enquanto um modelo maior revisa a conversa. Se a revisão reprova, a resposta é retida — você não recebe nada, ou recebe mais devagar. A OpenAI gastou mais de 700.000 horas de GPU em red-teaming automatizado e admite, no próprio anúncio, que trabalho legítimo de dual-use vai esbarrar nas travas durante o preview.
Na prática, pra quem trabalha com segurança da informação ou pesquisa biomédica: no Claude você recebe uma resposta de um modelo mais fraco; no GPT-5.6 você pode receber lentidão ou silêncio. Nenhum dos dois é confortável — o fallback da Anthropic é mais previsível, a pausa da OpenAI é mais opaca. Pra todo o resto dos usos, os dois afirmam que a trava é estatisticamente invisível.
Tem ainda a camada institucional: o GPT-5.6 foi o primeiro lançamento de IA gateado por governo — preview restrito a pedido da administração americana, aval do Departamento de Comércio pra ampliar. O Fable 5 passou por processo parecido só na versão sem trava (o Mythos 5, restrito ao Project Glasswing). Os detalhes estão nos posts de cada lançamento: GPT-5.6 e Claude Mythos 5.
Onde cada um ganha
GPT-5.6 Sol:
- Preço — metade do Fable 5, com Terra e Luna abaixo pra compor cascata de custo
- Trabalho agêntico de terminal (Terminal-Bench, com a ressalva de sempre)
- Latência: rodando na Cerebras a até 750 tokens/s em julho
- Cache previsível de 30 minutos pra agente de longa duração
Claude Fable 5:
- Um mês de uso público e relatos de terceiros acumulados (Stripe, Cognition, Cursor) — o GPT-5.6 ainda vai construir esse histórico
- Tarefa longa com memória persistente: ganho 3× maior que o Opus 4.8 no teste da Anthropic, e é o padrão que os parceiros de lançamento mais confirmaram
- Salvaguarda com comportamento previsível (fallback avisado, não pausa silenciosa)
- Ecossistema Claude Code maduro pra workflows com subagentes — o modo
ultrada OpenAI chega agora nesse terreno
Qual usar, por perfil
- Dev montando agente novo. Comece pelo GPT-5.6 — a economia por token financia a experimentação, e a família de três tiers deixa rotear tarefa fácil pro Luna e escalar o resto. Se a tarefa é maratona de codebase com contexto persistente, teste o Fable 5 antes de decidir: é o cenário onde ele mais se separa. O recorte completo de coding está em GPT-5.6 para programar.
- Time que já roda Claude. Trocar de ecossistema por benchmark de lançamento é armadilha conhecida. O custo de migração (prompts, ferramentas, avaliação) come a economia de token por meses. Espere o GPT-5.6 acumular uso real; reavalie quando houver medição independente.
- Operação sensível a custo. A conta é assimétrica: o degrau barato da OpenAI (Luna, US$ 1/US$ 6) não tem equivalente na geração Mythos da Anthropic. Pra volume, a família GPT-5.6 ganha por estrutura de preço antes de qualquer benchmark. Se a dúvida é como encaixar isso num processo de empresa, agentes de IA cobre os paradigmas — e montar esse sistema é o que a gente faz em sistemas sob medida.
Como decidir com dado próprio (em vez de benchmark alheio)
Nenhuma tabela deste post substitui um teste com o seu trabalho real. O método que a gente aplica em cliente antes de fechar contrato de volume é curto e cabe numa tarde:
- Separe 10 tarefas representativas do fluxo verdadeiro — não exemplos inventados. Inclua pelo menos duas difíceis (aquelas que o modelo atual erra) e duas triviais.
- Rode as mesmas tarefas nos dois, com prompts idênticos, e registre três colunas numa planilha: resultado aprovado sim/não, tokens consumidos, tempo de resposta.
- Avalie às cegas. Quem julga a qualidade não pode saber qual saída veio de qual modelo — vieses de marca contaminam a leitura mais do que se admite.
- Multiplique o consumo médio pela projeção mensal e compare o custo total, não o preço unitário. Um modelo que resolve em uma tentativa sai mais barato que um mais "econômico" que exige retrabalho.
Empatou em qualidade? O preço decide, e a matemática favorece a OpenAI nesta geração. O empate técnico com diferença de custo relevante é, aliás, o resultado mais comum que a gente encontra nesses testes — e é exatamente o cenário que as tabelas de divulgação nunca mostram.
Perguntas frequentes
GPT-5.6 ou Claude Fable 5: qual é melhor?
Depende da tarefa. No material da OpenAI, o GPT-5.6 Sol lidera o Terminal-Bench 2.1 (88,8% vs 84,3%) custando metade do preço; a Anthropic apresenta o Fable 5 como state-of-the-art nos benchmarks dela, com vantagem em tarefa longa e memória persistente. Não existe medição independente cruzando os dois ainda — a diferença de preço, essa é objetiva.
Qual é mais barato: GPT-5.6 ou Claude Fable 5?
O GPT-5.6 Sol custa US$ 5/US$ 30 por milhão de tokens (entrada/saída) — exatamente metade do Claude Fable 5, que custa US$ 10/US$ 50. Abaixo do Sol ainda existem o Terra (US$ 2,50/US$ 15) e o Luna (US$ 1/US$ 6), sem equivalente na geração Mythos da Anthropic.
As salvaguardas dos dois modelos funcionam igual?
Não. O Fable 5 redireciona consultas sensíveis (cyber, biologia, destilação) pro Claude Opus 4.8 e avisa o usuário — rebaixamento transparente. O GPT-5.6 pode pausar a geração em tempo real pra revisão por um modelo maior e reter a resposta. Ambas as empresas admitem falso positivo em trabalho legítimo de dual-use.
Vale migrar do Claude pro GPT-5.6?
Se a operação já roda bem no Claude, não por enquanto. Custo de migração de prompts e ferramentas come a economia de token por meses, e os números do GPT-5.6 ainda são do material de lançamento, sem validação independente. Vale testar em paralelo num fluxo novo e decidir com dado próprio.
Próximos passos
O detalhe de cada lançamento está em GPT-5.6: o que é, preço e quando chega e Claude Fable 5: o que muda. O panorama dos três ecossistemas — incluindo o Gemini, que ficou fora desta briga de julho — segue em Claude vs ChatGPT vs Gemini.
Fontes oficiais: Previewing GPT-5.6 Sol (OpenAI) e Claude Fable 5 and Claude Mythos 5 (Anthropic).
Publicado em 9 de julho de 2026, na semana da disponibilidade geral do GPT-5.6. Benchmarks são material de lançamento das duas empresas; este post recebe atualização quando houver medição independente cruzando os dois modelos.
Publicado em 08 de julho de 2026 · Por Equipe Huios